La première fois que j’ai vraiment pris la mesure de la quantité de données que nous produisons, c’était en cherchant une photo précise sur mon téléphone. Quelques mots dans la barre de recherche, et l’appareil a retrouvé un cliché vieux de plusieurs années, au milieu de milliers d’autres. Pratique, presque magique. Mais qu’est-ce qu’une donnée informatique, au juste ? Et comment quelques suites de chiffres peuvent-elles représenter une photo, un message ou une adresse ?
Le mot « donnée » est partout : dans les conversations sur la vie privée, les objets connectés, l’intelligence artificielle ou les entreprises numériques. Pourtant, il désigne une réalité assez simple. Une donnée informatique est une information représentée sous une forme que les appareils peuvent enregistrer, traiter et transmettre. Pour comprendre ce qui se cache derrière cette définition, il suffit de regarder de plus près ce qui se passe quand on clique, écrit ou photographie.
Une donnée informatique, c’est quoi ?
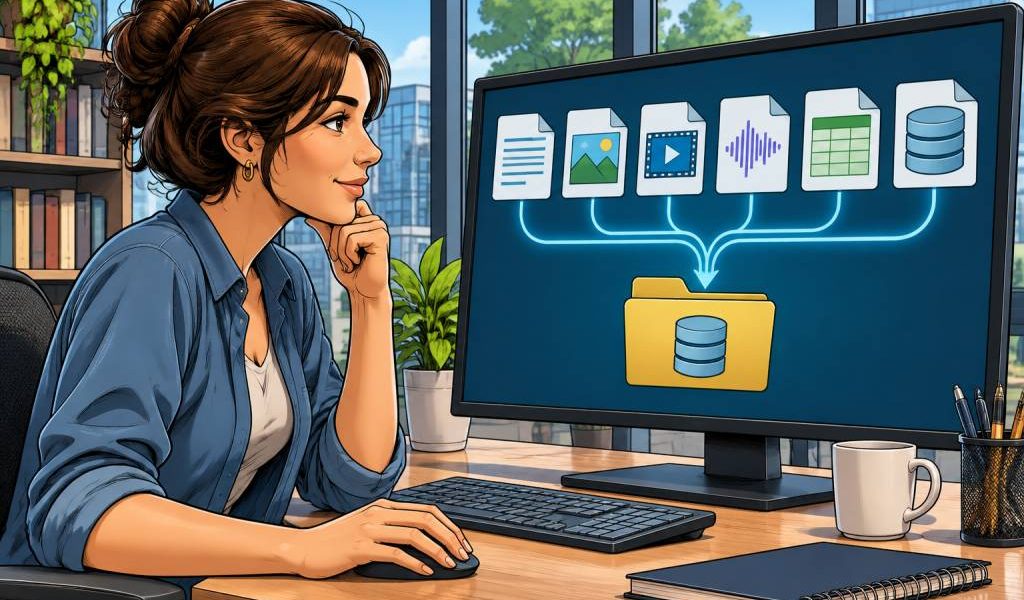
Une donnée est un élément d’information. Cela peut être un prénom, une date, un nombre, une mesure, un son ou une image. Dès qu’elle est encodée dans un format que l’ordinateur sait interpréter, elle devient une donnée informatique.
Le mot « encodée » est important. Un ordinateur ne comprend pas une photo comme nous la voyons, ni une phrase comme nous la lisons. Il manipule des valeurs numériques, représentées en pratique par des suites de 0 et de 1. Ces chiffres binaires correspondent à deux états électriques que les composants peuvent distinguer. À partir de ces états élémentaires, les appareils stockent et transforment des informations complexes.
Un fichier contenant le texte « Bonjour » n’est donc pas composé de petites lettres rangées dans une boîte. Les caractères sont associés à des codes, eux-mêmes représentés par des nombres. Le logiciel utilise ces codes pour afficher le mot sur l’écran. Même principe pour une image : les données décrivent notamment les couleurs et la position des points qui la composent.
On peut résumer ainsi : une donnée est une information représentée de manière exploitable par une machine. Elle devient utile lorsqu’un programme sait comment la lire et quoi en faire.
Les données sont partout, même quand on ne les remarque pas
Dans une journée ordinaire, nous croisons une quantité impressionnante de données. Lorsque vous envoyez un message, l’application traite le texte, l’identité du destinataire, l’heure d’envoi et parfois des informations sur l’appareil utilisé. Quand vous consultez la météo, votre téléphone reçoit des valeurs de température, de vent ou de précipitations. Et lorsque vous prenez une photo, il enregistre bien davantage que ce qui apparaît à l’écran.
Voici quelques exemples courants :
-
une donnée personnelle : un nom, une adresse électronique ou une date de naissance ;
-
une donnée de mesure : la température relevée par un thermostat ou le nombre de pas comptés par une montre ;
-
une donnée de contenu : le texte d’un message, une photographie, une vidéo ou un enregistrement sonore ;
-
une donnée de localisation : une position géographique fournie par un téléphone ;
-
une donnée technique : le modèle d’un appareil, la taille d’un fichier ou l’heure à laquelle une opération a eu lieu.
Ces informations n’ont pas toutes la même sensibilité. Le nombre de pages consultées sur un site et le contenu d’un dossier médical sont bien des données dans les deux cas, mais leurs conséquences en matière de confidentialité ne sont pas comparables.
Du bit au fichier : comment l’information est-elle représentée ?
Le bit est l’unité de base de l’information numérique. Il peut prendre deux valeurs : 0 ou 1. Les ordinateurs regroupent les bits pour représenter des nombres, des caractères et, à plus grande échelle, des fichiers entiers.
Un groupe de huit bits forme généralement un octet. Les capacités de stockage se mesurent ensuite en multiples : kilooctets, mégaoctets, gigaoctets et téraoctets. Une courte note occupe peu de place ; une vidéo en haute définition en réclame beaucoup plus, car elle contient une grande quantité d’informations visuelles et sonores.
La taille ne dit toutefois pas tout. Un fichier n’est pas seulement une suite de nombres : il faut aussi savoir comment les interpréter. Le format joue ici le rôle d’une sorte de mode d’emploi. Un fichier portant l’extension .jpg décrit une image d’une manière particulière ; un fichier .mp3 organise des informations sonores ; un document .pdf suit d’autres règles encore. Si le logiciel ne reconnaît pas le format, les données peuvent être présentes sans être lisibles correctement.
Autrement dit, posséder les ingrédients ne suffit pas toujours : encore faut-il avoir la recette. C’est aussi pour cela que les formats ouverts et les sauvegardes régulières comptent. Un fichier enregistré dans un format devenu illisible peut être difficile à récupérer, même si le support de stockage fonctionne encore.
Donnée, information et connaissance : trois notions proches
Dans la conversation courante, on emploie souvent « donnée » et « information » comme des synonymes. Il existe pourtant une différence utile. Une donnée est un élément brut ; une information apparaît lorsqu’on lui donne un contexte ou qu’on l’interprète.
Prenons le nombre « 18 ». Sans autre précision, il ne nous apprend pas grand-chose. Est-ce une température, un âge, une heure ou le nombre de messages reçus ? Si l’on précise qu’il s’agit de 18 degrés mesurés à Nantes à midi, la donnée devient une information plus compréhensible. Si l’on compare cette mesure à celles des années précédentes pour repérer une évolution, on commence à produire de la connaissance.
Cette distinction est particulièrement importante dans les organisations. Accumuler des données ne garantit pas qu’on en tirera des décisions utiles. Il faut qu’elles soient fiables, compréhensibles et adaptées à la question posée. Un tableau rempli de chiffres imprécis peut donner une impression de rigueur sans aider à y voir plus clair.
Les grandes familles de données informatiques
On peut classer les données selon leur nature, leur organisation ou leur usage. Cette classification aide à comprendre pourquoi elles ne se stockent pas toutes de la même façon.
Les données structurées suivent une organisation définie, souvent sous forme de tableau. Dans une liste de clients, chaque ligne peut correspondre à une personne et chaque colonne à une information : nom, ville, date d’inscription. Cette structure facilite les recherches et les comparaisons.
Les données non structurées n’obéissent pas à un tableau aussi régulier. Un courriel, une photo, une vidéo ou un document rédigé librement en sont des exemples. Elles contiennent beaucoup d’informations, mais leur analyse demande des outils capables de traiter leur contenu.
Entre les deux, on trouve des données semi-structurées. Un message électronique, par exemple, contient un texte libre, mais aussi des champs organisés : expéditeur, destinataire, objet et date. Il n’est ni aussi ordonné qu’un tableau classique ni totalement dépourvu de structure.
La différence entre ces familles n’est pas seulement théorique. Elle influence les outils utilisés, les méthodes de recherche et le coût du stockage. Une entreprise ne traite pas une facture numérisée exactement comme une liste de prix soigneusement rangée dans un tableau.
Comment les données sont-elles créées, stockées et utilisées ?
Une donnée peut être saisie directement par une personne, comme un commentaire publié sur un site. Elle peut aussi être produite automatiquement par un appareil : une montre connectée mesure un rythme cardiaque, une voiture enregistre une vitesse, un compteur relève une consommation électrique.
Une fois créée, elle peut être conservée sur un appareil, un serveur ou un service distant, souvent appelé « nuage informatique ». Cette expression peut donner l’impression que les fichiers flottent quelque part dans le ciel. En réalité, ils sont stockés sur des serveurs physiques, installés dans des centres de données et reliés à Internet.
Des logiciels peuvent ensuite consulter ces données, les modifier, les classer ou les transmettre. Une application de livraison, par exemple, utilise une adresse pour proposer des restaurants proches, un panier pour calculer le prix et des données de paiement pour finaliser la commande. Chaque étape mobilise des informations différentes, parfois détenues par des acteurs différents.
Le parcours d’une donnée mérite donc d’être regardé de près. Qui la collecte ? Où est-elle conservée ? Combien de temps ? Qui peut y accéder ? Peut-elle être supprimée ? Ces questions ne concernent pas uniquement les experts en informatique : elles touchent à nos usages quotidiens et à nos droits.
Pourquoi la qualité des données compte-t-elle autant ?
Une donnée incorrecte peut provoquer des erreurs très concrètes. Une faute dans une adresse de livraison, une date mal saisie dans un dossier ou une mesure défectueuse dans un capteur suffit parfois à fausser tout le traitement qui suit.
La qualité dépend notamment de l’exactitude, de la fraîcheur et de la cohérence des informations. Une adresse ancienne peut être exacte à un moment donné, puis devenir obsolète. Deux fichiers peuvent attribuer des dates différentes à une même opération. Une base de données peut aussi contenir plusieurs fois le même enregistrement.
On entend parfois l’idée que les données parleraient d’elles-mêmes. En réalité, elles ne parlent pas : ce sont les personnes et les logiciels qui les interprètent. Si les informations sont incomplètes ou biaisées, les résultats peuvent l’être aussi. Un outil d’aide à la décision, par exemple, ne devient pas juste simplement parce qu’il traite un grand nombre de données.
Données personnelles : quelles précautions adopter ?
Une donnée personnelle est une information qui permet d’identifier une personne, directement ou indirectement. Le nom et le numéro de téléphone sont des exemples évidents. Mais une combinaison d’informations moins reconnaissables — une localisation, un horaire régulier et un lieu de travail — peut également révéler l’identité ou les habitudes de quelqu’un.
Quelques réflexes simples permettent de mieux maîtriser ses données :
-
vérifier les autorisations demandées par les applications et retirer celles qui ne sont pas nécessaires ;
-
utiliser des mots de passe différents pour les comptes importants et activer la vérification en deux étapes lorsqu’elle est proposée ;
-
éviter de publier des informations personnelles qui ne sont pas utiles à la démarche ;
-
consulter les réglages de confidentialité des services utilisés ;
-
conserver une copie de sauvegarde des fichiers importants.
Ces gestes ne transforment pas un téléphone en coffre-fort inviolable. Ils réduisent toutefois les risques les plus courants et aident à garder la main sur une partie de son empreinte numérique.
Une notion simple, aux conséquences bien réelles
Une donnée informatique, au fond, est une information codée afin qu’un appareil puisse la conserver ou la traiter. Elle peut prendre la forme d’un chiffre, d’un texte, d’une image, d’un son ou d’une mesure. Son format, son contexte et sa qualité déterminent en partie ce qu’on peut en faire.
Cette définition paraît technique, mais ses enjeux sont très concrets. Les données organisent nos photos, facilitent des démarches, alimentent des services et orientent parfois des décisions importantes. La prochaine fois qu’une application vous demande une autorisation ou qu’un appareil semble « deviner » ce que vous cherchez, vous saurez qu’il ne s’agit pas de magie : derrière l’expérience se trouvent des données, des règles de traitement et des choix humains.